
批量字幕提取,慢的不是识别,而是返工
识别、断句、时间轴和格式问题会在整批素材中反复出现,返工因此成为批量字幕项目的主要耗时。
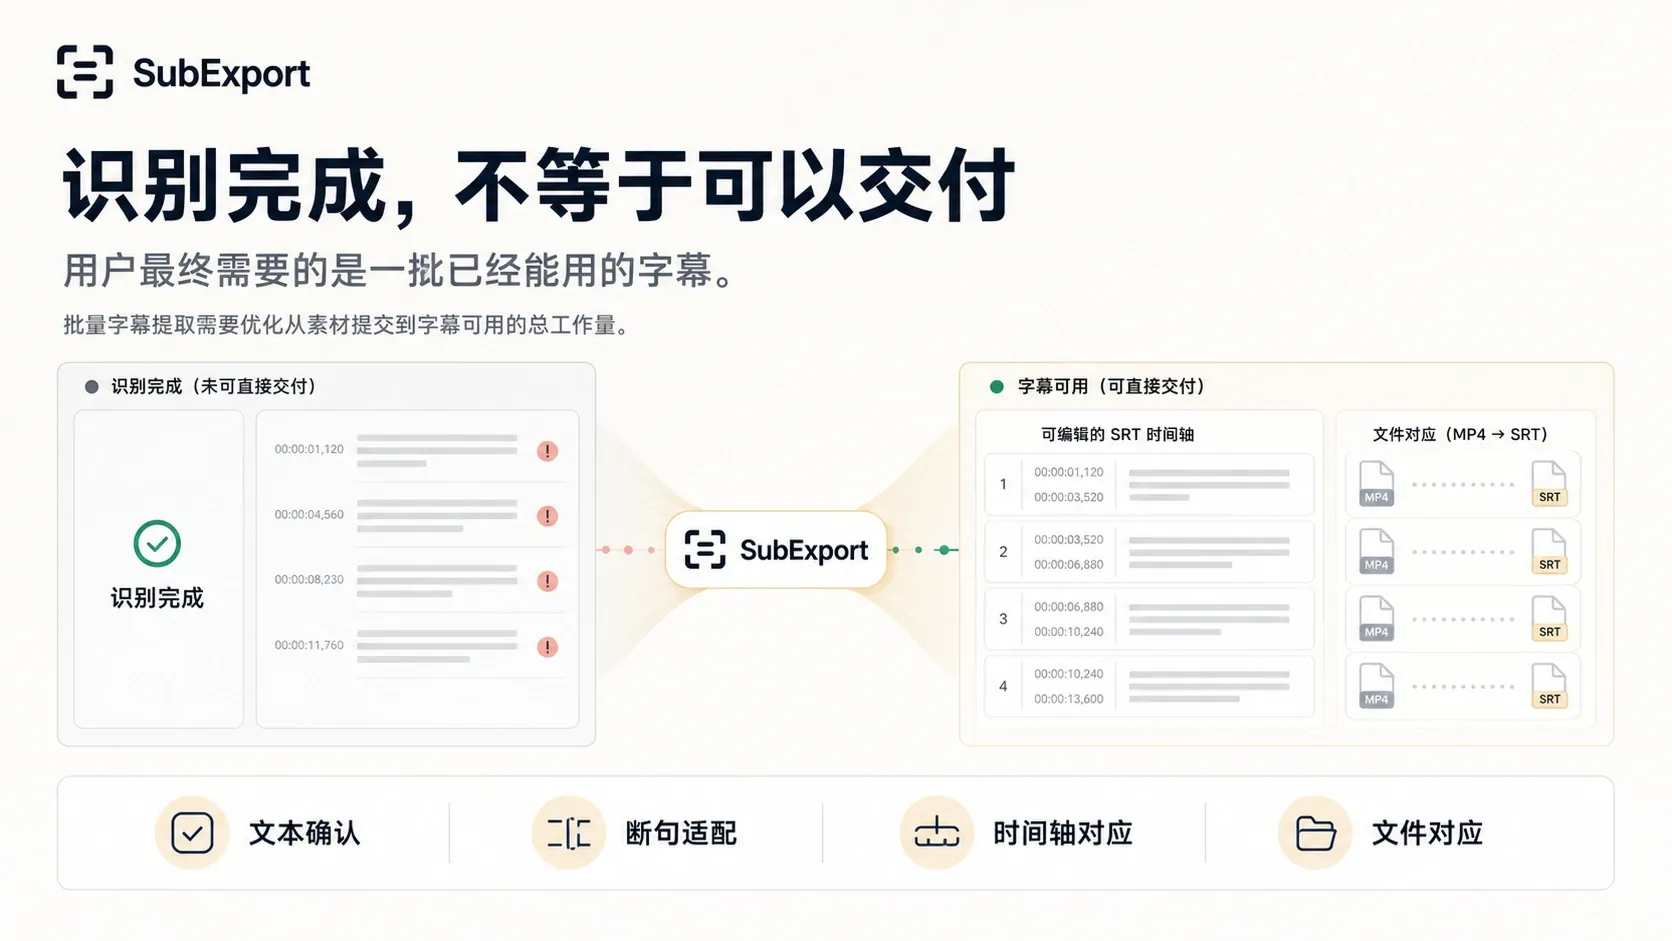
一批视频很快显示处理完成,团队却没有马上进入下一步。有人开始逐条检查错字,有人重新拆分长句,还有人把字幕拖回剪辑软件调整时间轴。
单条视频只改几处,看起来不算麻烦。但当素材变成几十集短剧、几十节课程或几小时采访,零散的小修改会迅速变成一项持续返工。
批量字幕提取需要优化从素材提交到字幕可用的总工作量。
一、字幕提取得很快,项目为什么还是交不出去?
因为识别完成和可以交付是两个不同状态。
语音转成文字,只解决了字幕从无到有。接下来,团队还要确认文本是否准确、句子是否适合字幕阅读、时间轴是否对应语音,以及文件能否找到对应视频。
传统流程通常把这些工作留到最后:先追求批量跑完,再集中打开文件修改。结果是处理进度看起来很快,交付进度却一直停在原地。
用户最终需要的是一批已经能用的字幕。
二、返工通常集中在识别、断句和时间轴
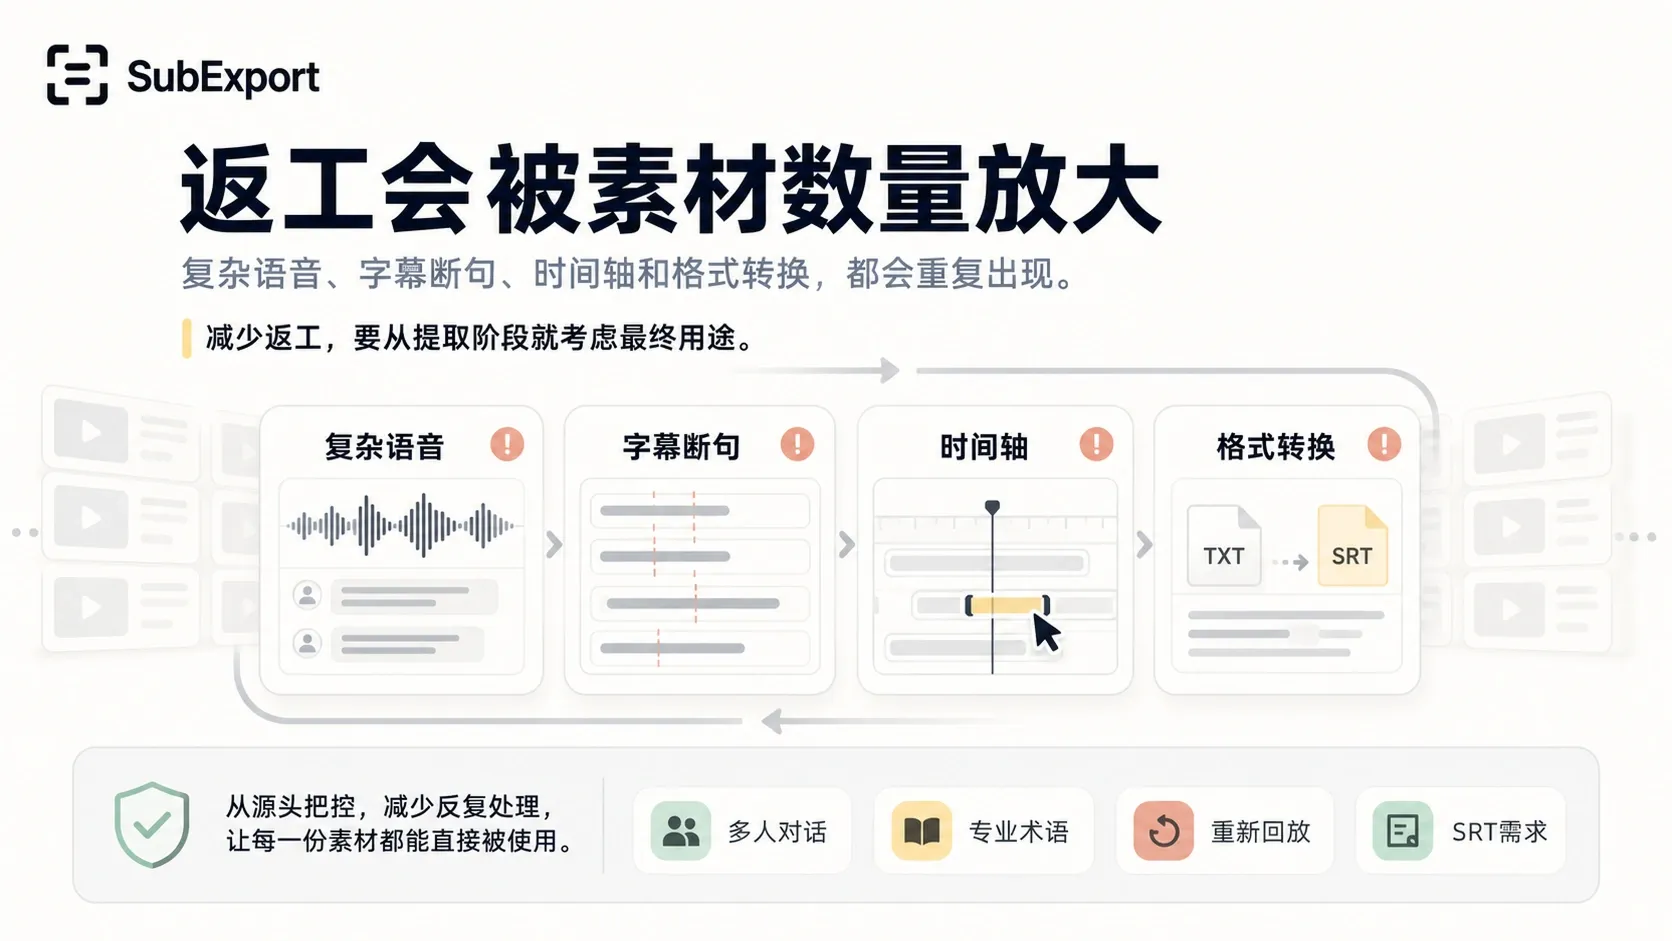
第一类返工来自复杂语音。多人轮流说话、专业术语、轻微环境噪音和音量不均,都可能带来漏听、错听,需要团队重新回放确认。
第二类返工来自字幕断句。口语里一句话可能很长,如果直接按照停顿机械切分,字幕会出现上一行没有说完、下一行突然接续的情况,阅读和翻译都会受影响。
第三类返工来自时间轴。文字内容即使正确,只要出现时间与语音不匹配,放回视频后仍然需要逐条移动。
这三类问题叠加起来,才是批量字幕任务中最容易被低估的成本。
还有一类常见返工来自格式转换。团队先拿到纯文本,后来才发现剪辑需要SRT,于是又要重新划分字幕并建立时间轴。即使没有识别错误,格式转换仍会占用大量后期时间。
三、单条字幕的小修改,会被素材数量成倍放大
可以做一个简单的项目估算:假设一条视频提取后只需要5分钟检查和调整,40条视频就是200分钟。这里还没有计算下载、改名、重新导入和成员之间交接的时间。
这是一个用于理解批量成本的假设场景,不代表实际项目效果数据。它说明:批量场景中,决定总工时的往往不是单次识别,而是每条素材都会重复发生的后续动作。
所以,单条测试时改一下就好的问题,进入整批生产后可能会成为主要工作量。
再比如一门20节的课程,每节只有少量专业名词需要修改。如果字幕文件可以编辑、课节命名清楚,课程团队可以快速定位;如果结果散落在多份纯文本中,校对人员还要先找到对应视频和时间位置。同样是修改术语,前置整理方式不同,工作量也完全不同。
四、减少返工,要从提取阶段就考虑最终用途
如果字幕只用于快速了解视频内容,纯文本可能已经足够;如果要继续剪辑、翻译或发布,交付要求就完全不同。
用于后期的字幕,需要可编辑、断句清楚并带有时间轴;用于系列内容的字幕,还需要与原视频保持清晰对应。
这意味着,团队应该在开始提取前就说明结果将用于什么场景,而不是等所有文件完成后再补做格式和整理。
例如采访素材既可能用于整理文章,也可能用于剪辑成片。前者关注文字是否完整,后者还需要断句和时间轴。如果一开始只按纯文本处理,到了剪辑阶段就不得不把已经完成的内容重新加工。
因此,减少返工需要从一开始就让交付规格与最终用途保持一致,不能把压力集中到最后的检查环节。把错误和格式问题留到整批完成后集中处理,通常只会让定位和回查更困难。
五、SubExport把减少返工放进完整交付流程
SubExport针对整批视频字幕项目,优先从画面硬字幕恢复文字和时间轴;没有可用硬字幕时,再通过语音识别补充生成字幕。
对于多人对话、专业术语、轻微噪音和音量不均等常见内容,会针对识别场景进行处理;随后继续整理字幕断句和时间轴,并交付可编辑的字幕文件。
用户不必在多个工具之间反复转存,也不必先拿到一批原始文字,再重新组织团队逐条收尾。SubExport将批量提取、字幕整理和文件交付放在一条流程中,减少重复修改和二次加工。
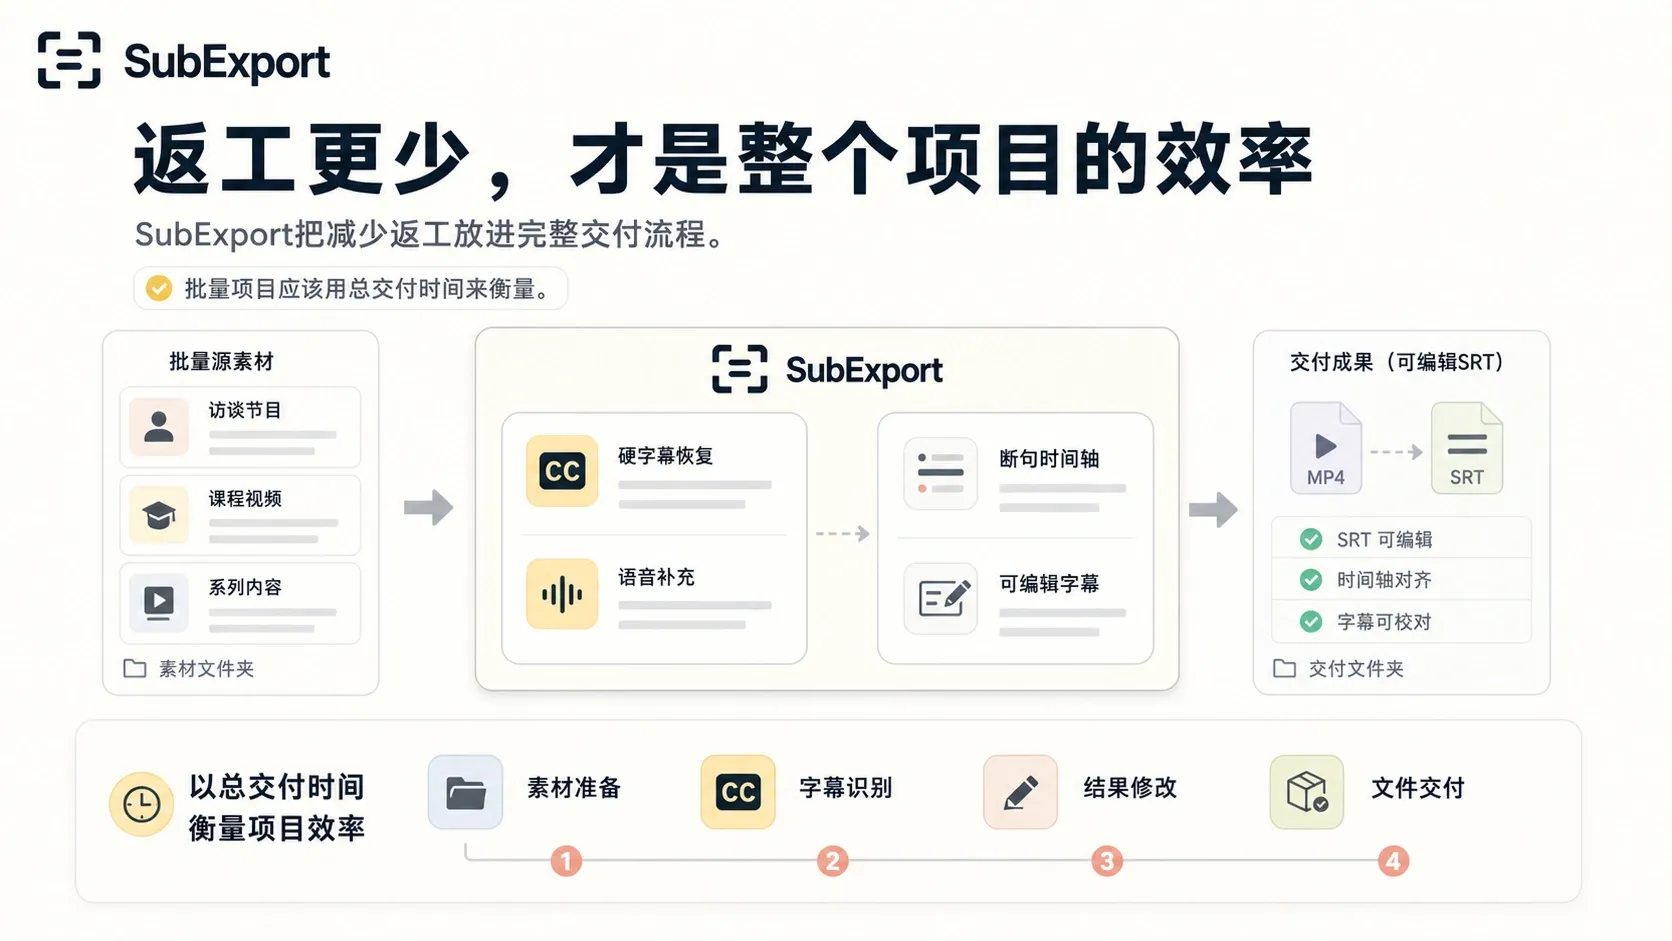
识别更快只是局部效率,返工更少才是整个项目的效率。
六、批量项目应该用总交付时间来衡量
下一次比较字幕提取方案时,可以把时间拆成四段:素材准备、字幕识别、结果修改和文件交付。只有四段加在一起明显缩短,才是真正的降本增效。
还可以记录一次批量任务中重新打开原视频的次数。每一次回放通常都意味着识别、断句、时间轴或文件对应没有在前面解决。这个指标虽然简单,却比进度条更接近真实工作量。
如果你正在处理多人采访、专业课程、多集短剧或复杂录音,可以提供素材类型、数量和字幕用途,由SubExport按最终使用场景完成批量提取与可编辑字幕交付。
了解 SubExport
查看介绍与样片:SubExport 产品介绍与样片
联系我们:提交项目需求